 DeveloperOC
유니티6 최적화 최신 기술 완전 분석
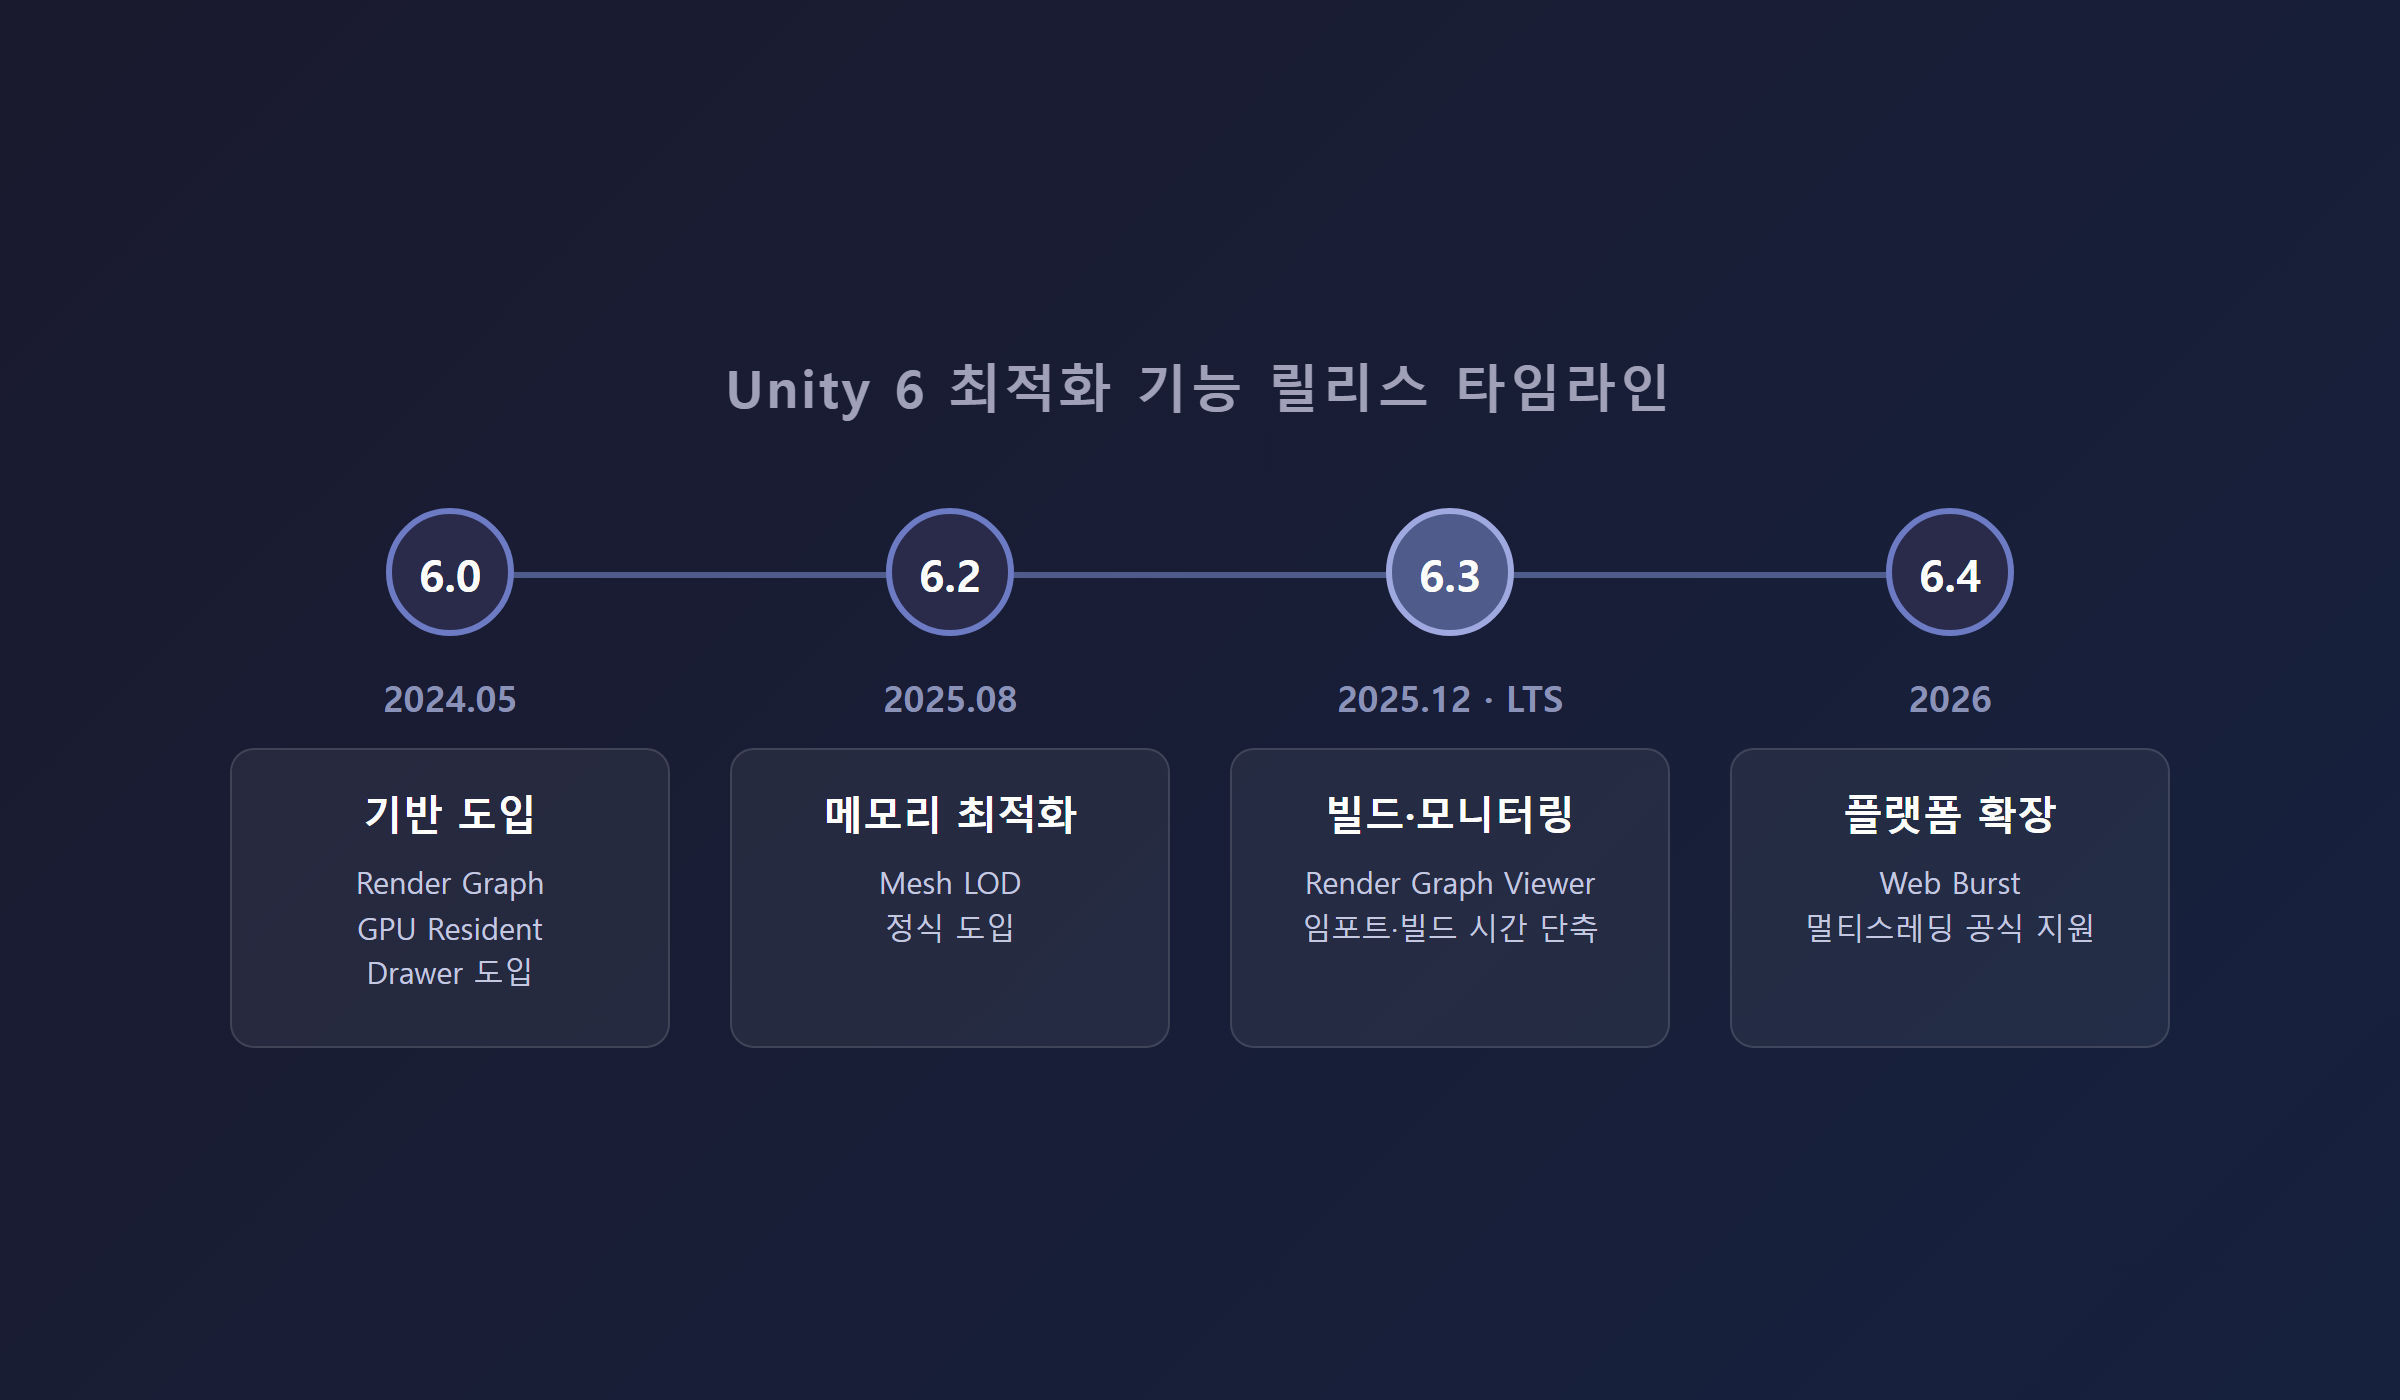
Unity 6(6000.x)는 2024년 5월 프리뷰 공개 이후 6.0, 6.2(2025년 8월), 6.3 LTS(2025년 12월), 6.4(2026년)까지 순차적으로 업데이트되면서 최적화 관련 기능을 계속 늘려왔습니다. 공식 문서와 발표 자료를 쭉 훑어보면, 이 흐름은 결국 몇 가지 축으로 정리됩니다. 렌더링 파이프라인의 CPU 부하를 줄이는 GPU Resident Drawer·Render Graph, Job System과 Burst 컴파일러의 플랫폼 확장, Incremental GC·Mesh LOD를 통한 메모리 관리, Incremental Build Pipeline을 통한 빌드 시간 단축, Adaptive Probe Volumes·Adaptive Performance 기반 모바일 대응, 마지막으로 정식 기능으로 승격된 ECS/DOTS입니다.
나는 이걸 “예전에는 프로파일러 찍고 개발자가 손으로 하나하나 줄이던 최적화 작업을, 엔진이 구조적으로 미리 흡수해주는 방향으로 가고 있다”고 이해하고 있습니다. 다만 모든 기능이 공짜로 성능을 벌어다 주는 것은 아니고, 특히 GPU Resident Drawer처럼 CPU 부하는 줄지만 GPU 부하나 빌드 시간이 늘어나는 트레이드오프가 있는 기능도 섞여 있어서, 결국은 “무조건 켠다”가 아니라 프로파일링을 통해 우리 프로젝트에 맞는지 확인하는 과정이 여전히 필요합니다.
왜 다시 최적화를 들여다봐야 하는가?
씬에 오브젝트가 많아질수록 CPU가 각 GameObject에 대해 드로우 콜을 하나씩 준비하는 비용이 누적됩니다. 특히 동일한 메시·셰이더를 쓰는 오브젝트가 수백 개씩 있는 씬에서는 렌더링 자체보다 “렌더링을 준비하는 CPU 작업”이 병목이 되는 경우가 많습니다.
문제점 요약: 기존 Unity 방식은 GameObject 단위로 SetPass Call과 드로우 콜을 개별적으로 처리했기 때문에, 오브젝트 수가 늘어날수록 CPU 프레임타임이 선형적으로 늘어나는 구조였습니다.
Unity 6 최적화 기능들의 역할: GPU Resident Drawer와 Render Graph는 이 CPU 준비 비용을 줄이는 방향으로, Job System·Burst와 ECS/DOTS는 게임플레이 로직 자체를 멀티스레드로 분산하는 방향으로, Incremental GC·Mesh LOD·Incremental Build Pipeline은 메모리와 빌드 파이프라인 쪽 병목을 줄이는 방향으로 각각 역할이 나뉩니다.
Render Graph는 렌더링을 어떻게 바꿨나?
URP 17(Unity 6.0부터 도입)의 Render Graph는 렌더 패스와 리소스 할당을 자동으로 최적화해주는 새로운 렌더링 프레임워크입니다. 여러 렌더 패스를 하나로 병합하고, 해당 프레임에서 쓰이지 않는 리소스는 아예 할당하지 않으며, 최종 프레임 출력에 반영되지 않는 렌더 패스는 실행을 건너뛰고, 리소스가 중복 생성되는 것도 막아줍니다.
특히 인상적인 부분은 모바일 대응입니다. Render Graph는 컴퓨트 큐와 그래픽스 큐 사이의 동기화 지점을 올바르게 만들어 프레임 타임을 줄이는데, 타일 기반 지연 렌더링(TBDR) 방식을 쓰는 모바일 환경에서는 여러 렌더 패스를 하나의 네이티브 렌더 패스로 병합할 수도 있습니다. 볼륨 프레임워크의 CPU 성능도 모든 플랫폼, 특히 모바일에서 최적화됐다고 공식 문서에 명시되어 있습니다. Unity 6.3부터는 Render Graph Viewer가 추가돼서, 실제 디바이스에서 렌더 그래프가 어떻게 실행되는지 실시간으로 모니터링할 수 있게 됐습니다.
GPU Resident Drawer, CPU 부하를 정말 30~50% 줄여주나?
GPU Resident Drawer는 Unity의 내부 렌더링 시스템으로, BatchRendererGroup API를 자동으로 활용해 GameObject를 GPU 인스턴싱으로 그려줍니다. 동일한 메시와 셰이더 변형을 쓰는 여러 GameObject를 하나의 드로우 콜로 묶어서 CPU 처리 시간과 SetPass 호출을 줄이는 방식입니다.
Unity는 GDC 2024 발표에서 “콘텐츠에 따라 다르지만 CPU 워크로드를 30~50%까지 줄이는 동시에 다양한 플랫폼에서 더 원활하고 빠르게 렌더링할 수 있다”고 밝혔고, 특히 대규모·복잡한 씬에서는 하이엔드 모바일·PC·콘솔 전반에서 최대 50%의 CPU 프레임타임 절감이 가능하다고 설명했습니다. 함께 동작하는 GPU Occlusion Culling도 프레임당 오버드로우를 줄여서 화면에 안 보이는 요소에 렌더링 자원을 낭비하지 않게 해줍니다.
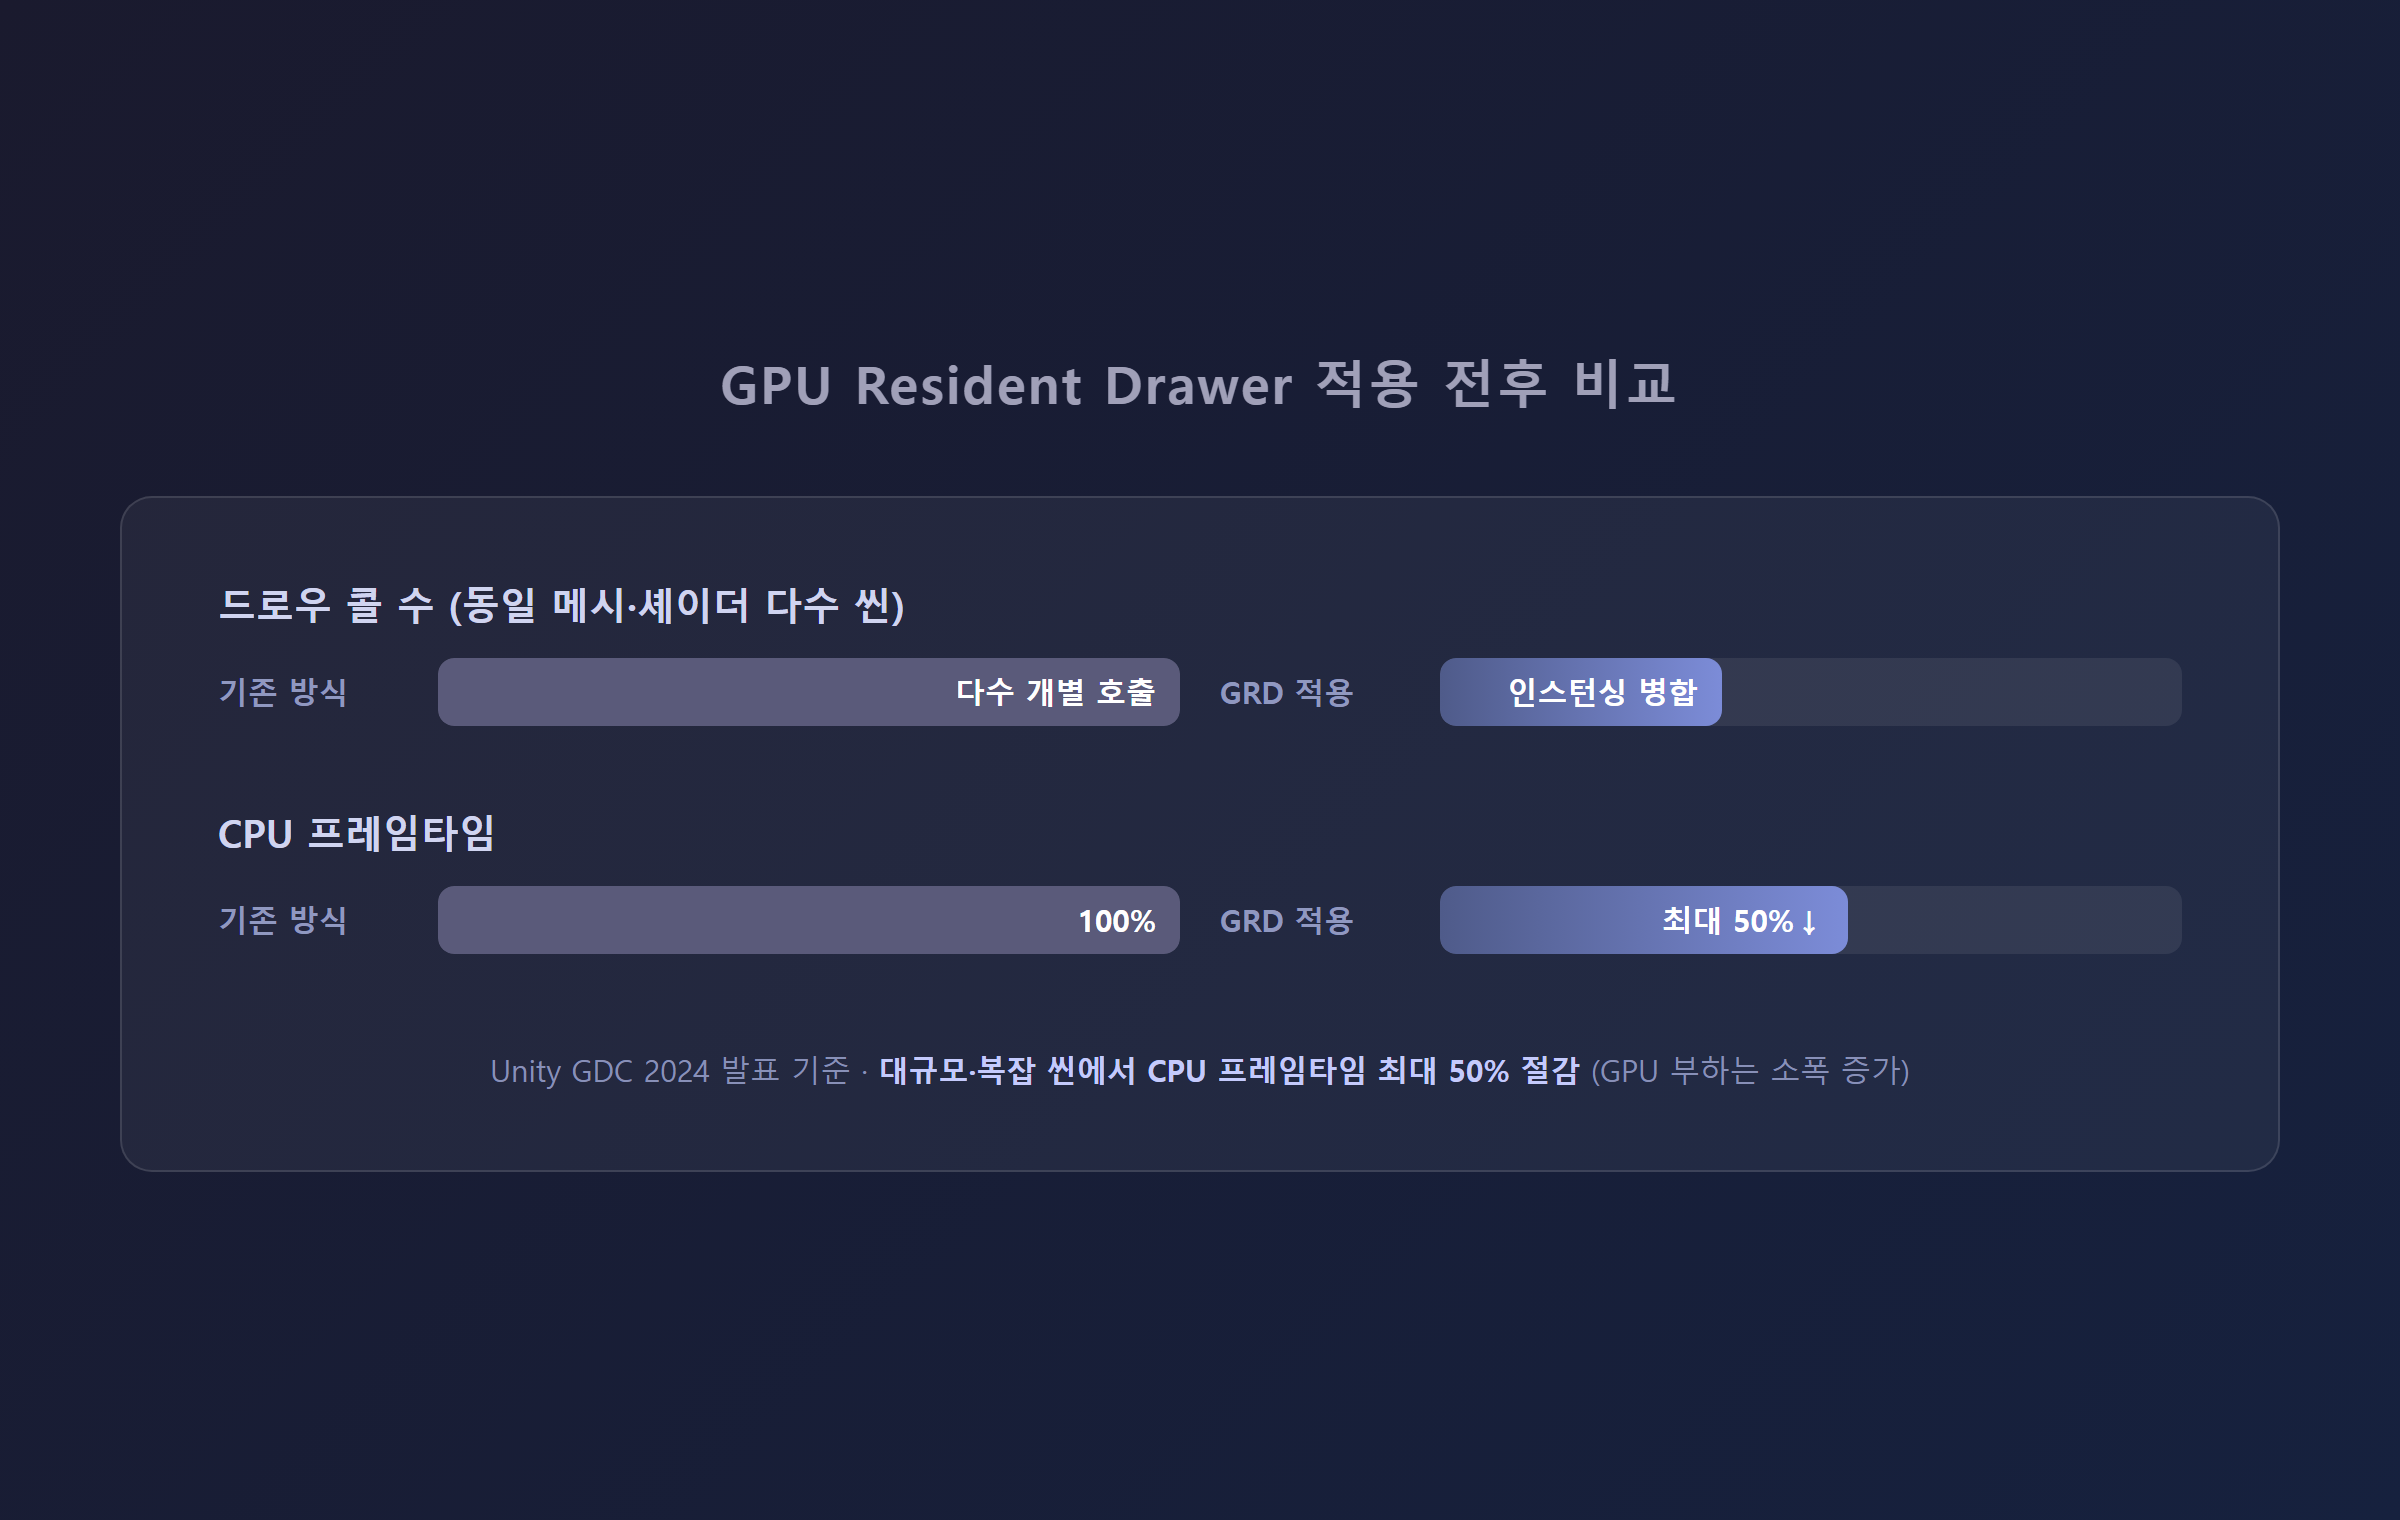
여기서 짚고 넘어가야 할 게 있습니다. 이 30~50%라는 수치는 Unity의 마케팅 발표(GDC 2024) 기준이고, 공식 성능 고려사항 문서는 이와 별개로 트레이드오프를 분명히 명시하고 있습니다. GPU Resident Drawer는 CPU 성능은 개선하지만 GPU 작업량을 약간 증가시키며, 이 현상은 모바일이나 VR 플랫폼에서 더 두드러집니다. GPU 바운드 애플리케이션이라면 오히려 전체 프레임 시간이 늘어날 수도 있다는 것이 공식 문서의 설명이라, “무조건 켜면 이득”이라기보다는 씬별로 Frame Debugger와 Profiler로 실측해야 한다는 게 (본인 기준) 더 중요한 결론이라고 생각합니다. 활성화 조건도 까다로운 편인데, Forward+ 렌더링 경로와 컴퓨트 셰이더를 지원하는 그래픽 API(OpenGL ES는 제외)가 필요하고, Player Settings에서 BatchRendererGroup을 “Keep All”로, URP Asset에서 SRP Batcher를 활성화, GPU Resident Drawer를 “Instanced Drawing”으로 설정한 뒤 렌더링 경로를 Forward+로 바꿔야 합니다.
또 하나 실무적으로 걸리는 부분은, GPU Resident Drawer가 기존 Static Batching과는 함께 동작하지 않아서 도입 시 Static Batching을 꺼야 한다는 점, 그리고 모든 BatchRendererGroup 셰이더 변형을 빌드 시점에 미리 컴파일해두기 때문에 빌드 시간이 늘어난다는 점입니다.
Job System과 Burst 컴파일러는 왜 같이 써야 하나?
Burst 컴파일러는 자동 벡터화(SIMD), 루프 언롤링, 함수 인라이닝, 데드 코드 제거 같은 공격적인 최적화를 수행합니다. LLVM 백엔드를 사용해서 Windows, macOS, Linux, iOS, Android, 콘솔 등 Unity가 지원하는 플랫폼별로 최적화된 네이티브 코드를 만들어줍니다. Job System은 이 Burst와 함께 동작하도록 설계돼 있어서, 멀티코어 프로세서를 최대한 활용하는 멀티스레드 코드를 짤 수 있게 해줍니다.
2026년 들어 가장 눈에 띄는 소식은 Unity 6.4에서 Web(WebGL) 플랫폼에 대한 Burst 기반 멀티스레딩과 C# Job System이 공식 지원되기 시작했다는 점입니다. 그동안 웹 빌드는 멀티스레드 활용에서 소외돼 있었는데, 이제는 백그라운드 워커 스레드로 job을 병렬 실행할 수 있게 된 겁니다. 다만 이걸 쓰려면 Burst 패키지 1.8.26 이상이 필요하고, 프로젝트 설정에서 “Enable Native C/C++ Multithreading”을 켜야 합니다. [BurstCompile]이 붙은 job만 워커 스레드에서 실행되고, 붙지 않은 job은 그냥 메인 스레드에서 돌아간다는 점도 실무에서는 헷갈리기 쉬운 부분입니다. Burst로 컴파일된 코드는 가비지 컬렉터와 무관하게 동작해서 GC 정지 시간의 영향을 받지 않는다는 점도 Burst를 쓰는 이유 중 하나입니다.
메모리 최적화: Incremental GC와 Mesh LOD
Unity 6는 기본적으로 Incremental Garbage Collection을 씁니다. Boehm-Demers-Weiser GC를 incremental 모드로 돌려서 GC 작업을 여러 프레임에 걸쳐 나누고, 메인 스레드를 짧게 여러 번 멈추는 방식입니다. VSync나 Application.targetFrameRate를 설정해두면 프레임 끝에 남는 시간을 GC 실행에 활용합니다.
다만 여기에도 트레이드오프가 있습니다. 참조가 바뀔 때마다 GC에 알리는 “write barrier” 코드가 추가로 생성돼서 약간의 오버헤드가 붙습니다. 성능이 크리티컬한 구간에서 GC 자체를 유발하지 않도록 짜여 있는 프로젝트라면 Incremental GC를 굳이 켜둘 필요가 없다고 매뉴얼도 언급하고 있어서, Project Settings나 GarbageCollector.GCMode API로 상황에 맞게 끄고 켤 수 있다는 걸 알아두면 좋습니다. 웹 플랫폼은 애초에 Incremental GC를 지원하지 않는다는 점도 참고할 부분입니다.
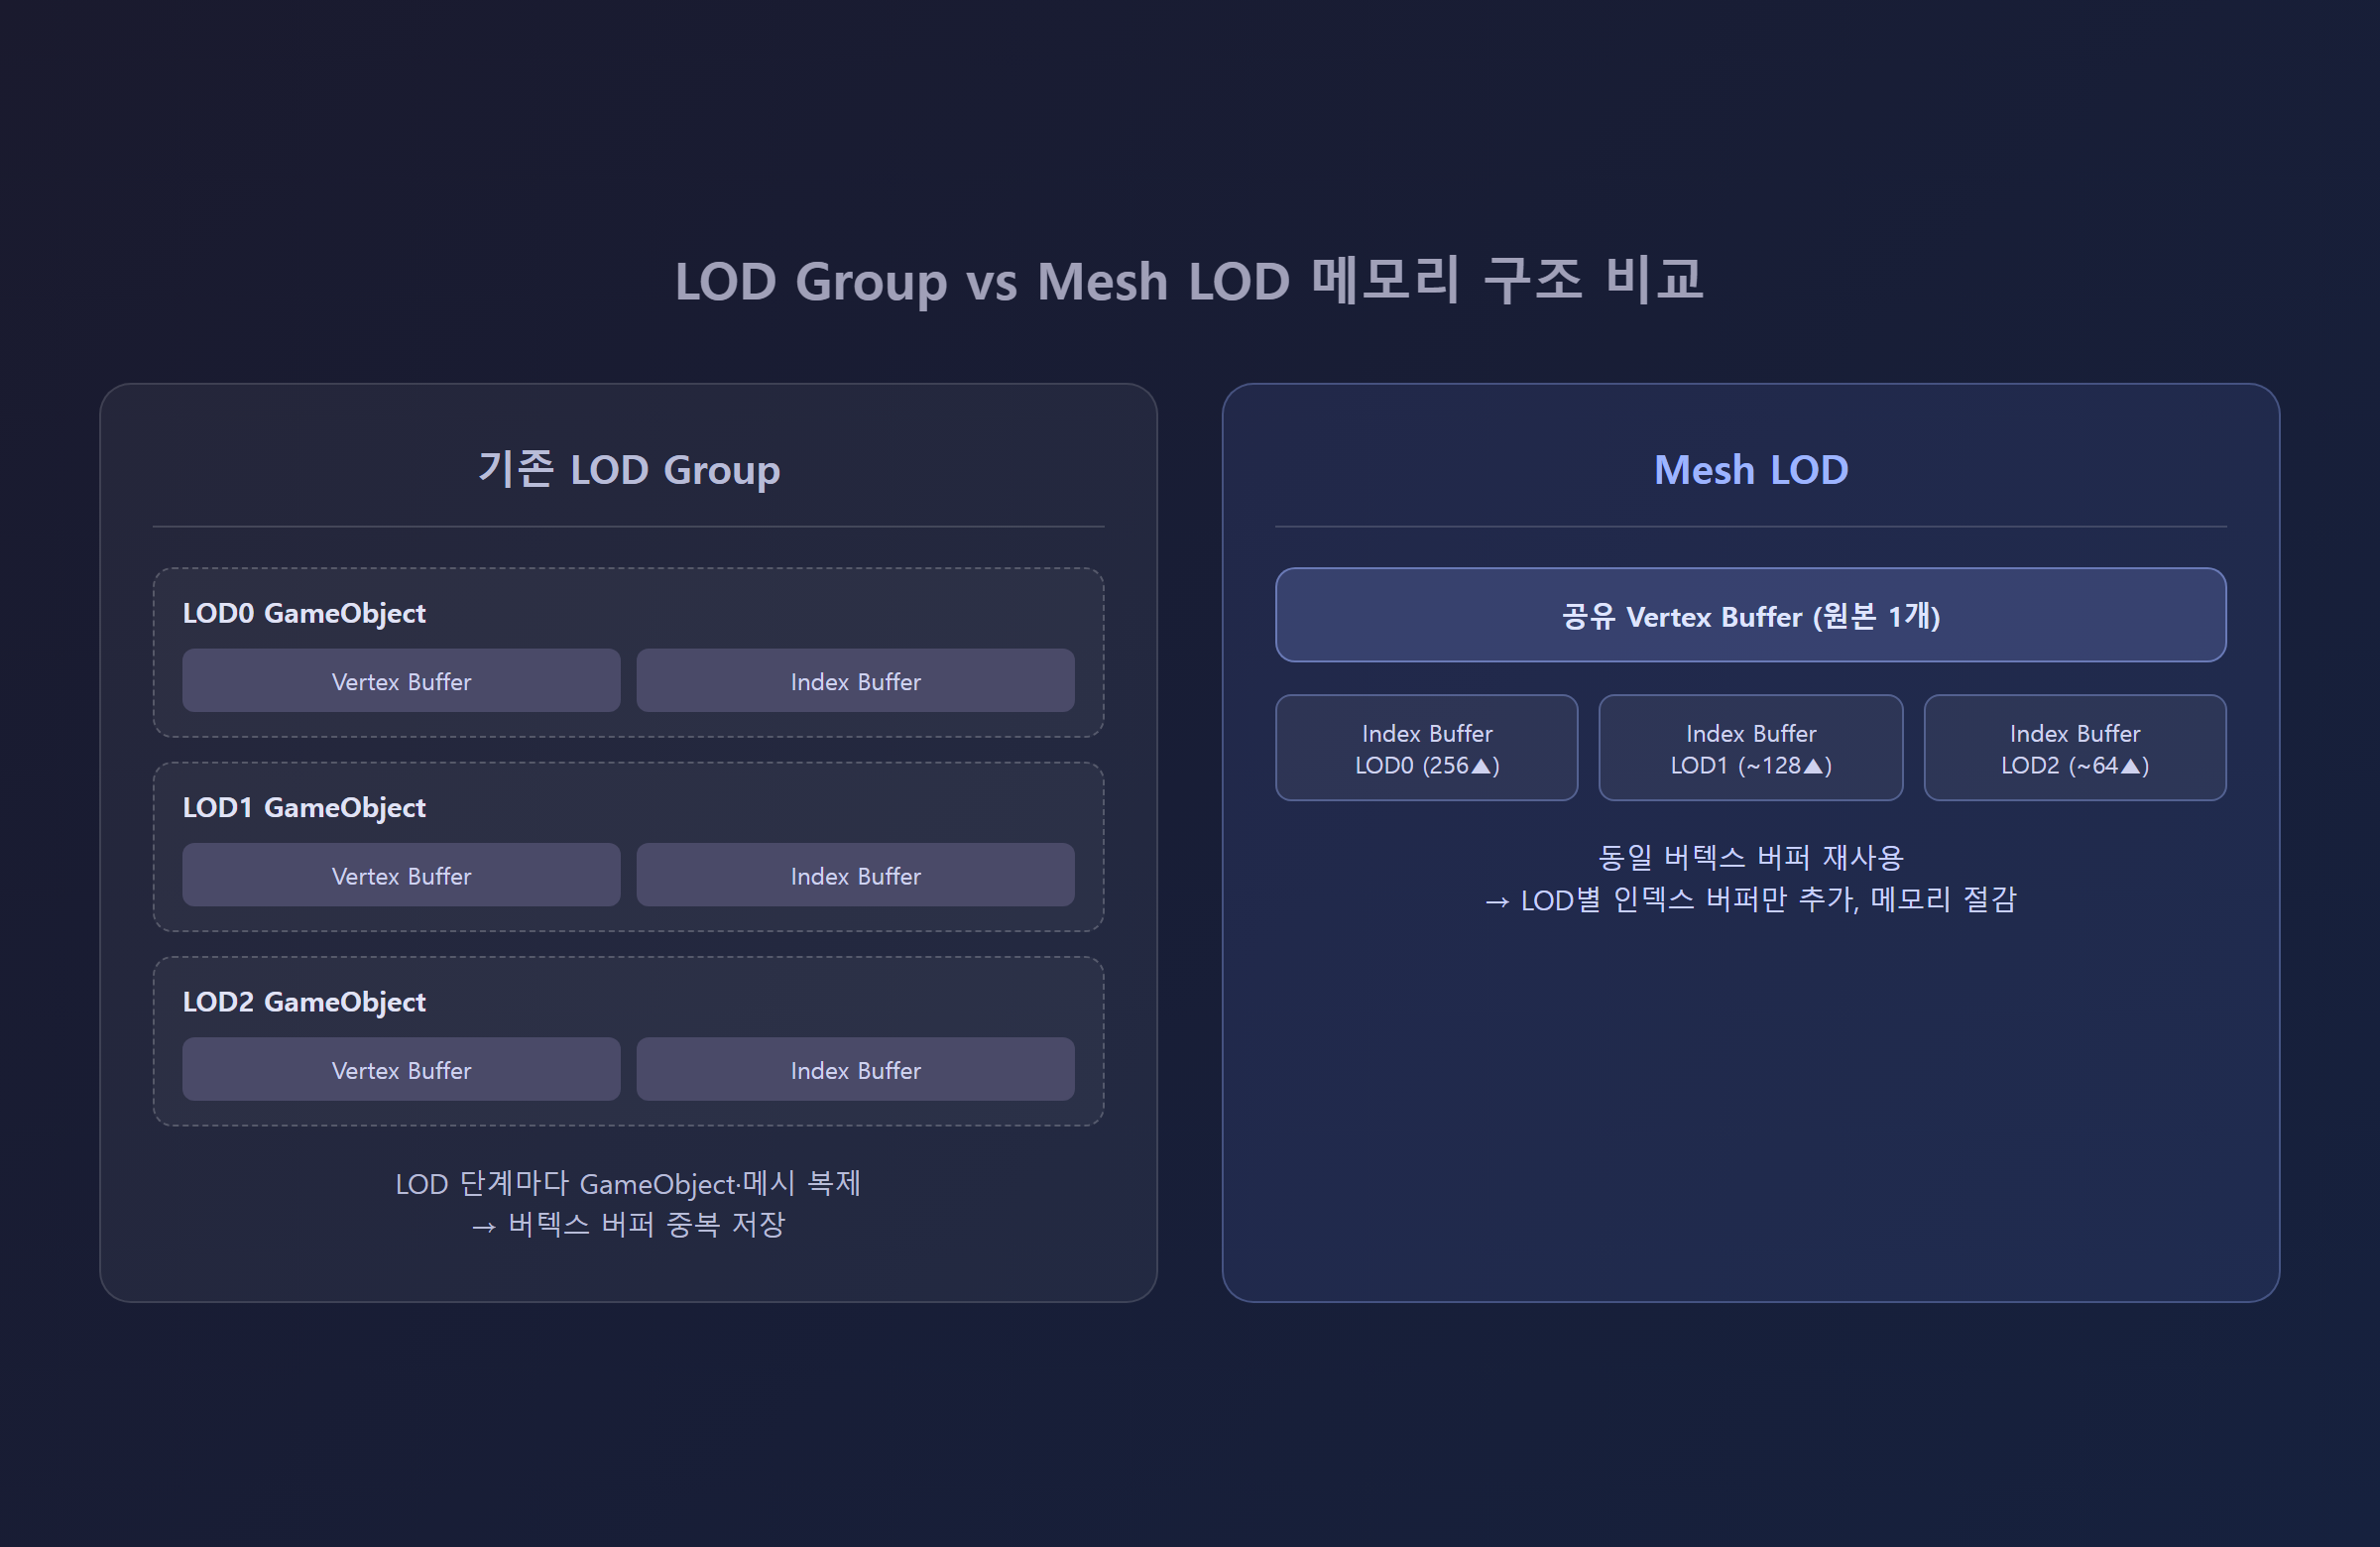
Mesh LOD는 Unity 6.2에서 정식 도입된 기능인데(2025년 4월 알파로 첫 공개), 임포트 시점에 자동으로 LOD 메시를 생성·관리해줍니다. 기존 LOD Group 방식은 LOD 단계마다 별도 GameObject를 만들고 메시를 복제해야 했는데, Mesh LOD는 모든 LOD를 원본 메시의 인덱스 버퍼에 저장하고 동일한 버텍스 버퍼를 재사용하는 방식이라 메모리 사용량 자체가 줄어드는 구조입니다. 단순화 알고리즘은 256 삼각형에서 시작해서 반복마다 대략 절반씩 삼각형을 줄여가며 64 삼각형 근처에서 멈춥니다.
빌드 시간은 얼마나 줄었나?
스크립트 컴파일과 플레이어 빌드 파이프라인이 모두 incremental(증분) 방식으로 바뀌었습니다. 이전 빌드 이후 내용이 바뀌지 않았다면 이전 빌드 결과물을 그대로 재사용하고, 콘텐츠 빌드·코드 컴파일·데이터 압축·서명 등 각 단계에서 실제로 입력이 바뀐 부분만 다시 실행합니다. Mono와 IL2CPP 모두 지원하고 릴리스·개발 빌드 양쪽에서 기본적으로 켜져 있습니다. 캐시는 프로젝트 레벨(Library/Bee, Library/PlayerDataCache)과 머신 레벨(BEE_CACHE_DIRECTORY) 두 군데에 저장되고, 전체 재빌드가 필요하면 Build 버튼 팝업 메뉴의 “Clean Build”나 BuildOptions.CleanBuildCache API를 쓰면 됩니다. 플레이어 빌드 코드가 Bee 빌드 시스템으로 옮겨가면서 Burst 컴파일러도 이 증분 파이프라인에 통합돼, 다른 빌드 작업과 병렬로 돌고 어셈블리가 실제로 바뀐 경우에만 재실행됩니다.
2025년 12월 4일 출시된 Unity 6.3 LTS(2027년 12월까지 2년 지원)는 임포트 시간, Play 모드 진입 속도, 빌드 시간을 모두 단축시켰다고 알려져 있습니다. 특히 새로운 Shader Build Settings로 코딩 없이 키워드별 셰이더 변형 수를 제한할 수 있게 돼서 셰이더 컴파일 시간을 크게 줄일 수 있고, IL2CPP가 메타데이터에 가변 크기 인덱스를 쓰도록 개선돼 빌드 크기도 줄었습니다. 프로젝트에서 안 쓰는 물리 SDK 백엔드를 비활성화해서 빌드 크기를 추가로 줄이는 것도 가능해졌습니다. 덧붙여 Legacy Animation 평가 시간이 애니메이션 오브젝트 복잡도에 따라 최대 30%까지 줄었고, Box2D v3 통합으로 2D 물리의 멀티스레드 성능과 결정성이 함께 개선됐습니다.
모바일 최적화: APV와 Adaptive Performance
Adaptive Probe Volumes(APV)는 실시간 글로벌 일루미네이션 시스템으로, 계층적 프로브 그리드에 라이팅 정보를 베이크합니다. 복잡한 지오메트리·라이팅이 있는 영역에는 프로브를 더 촘촘히, 열린 공간에는 더 성기게 배치해서 품질과 메모리·성능 사이 균형을 맞추는 방식이고, 오브젝트 단위가 아니라 픽셀 단위로 라이팅을 계산해서 정확도도 높습니다. 모바일이나 메모리가 빠듯한 환경을 위해 APV 데이터 스트리밍도 지원하는데, 실제 사용 가능한 CPU/GPU 메모리보다 큰 APV 데이터를 미리 베이크해두고 필요할 때만 런타임에 불러올 수 있습니다. URP는 카메라 시야 절두체 안에 있는 셀의 APV 데이터만 로드하는 방식으로 이걸 구현합니다.
다만 프로브 밀도를 라이팅 품질 향상에 별 도움이 안 되는 곳까지 과도하게 높이면 그만큼 불필요한 메모리 비용이 든다는 지적도 있어서, 이 부분은 씬 구조를 보면서 조절해야 하는 영역이라고 생각합니다. Android에서는 기기별 최적 텍스처 압축 포맷을 골라주는 “텍스처 압축 포맷 타게팅” 기능이 있고, 저사양 하드웨어에서는 적응형 프로브 볼륨 자체가 CPU 성능을 끌어올려준다고 매뉴얼에 나와 있습니다. Adaptive Performance 패키지는 기기의 열·배터리 상태에 맞춰 품질을 동적으로 조절해주는데, Visual Scripting 지원이 추가돼서 C# 코드 없이도 지표에 접근할 수 있게 됐습니다. Unity 6.3부터는 Adaptive Performance가 엔진에 기본 통합돼 여러 플랫폼에서 프레임레이트 데이터를 캡처할 수 있고, Android XR에서는 자동 동적 해상도 조정 기능도 추가됐습니다.
ECS/DOTS는 이제 실험 딱지를 뗐다
DOTS(Data-Oriented Technology Stack)와 ECS(Entity Component System)는 Unity 6에서 실험적 상태를 벗어나 핵심 기능으로 자리잡았습니다. GameObject와 호환되는 데이터 지향 프레임워크로, 대규모 시뮬레이션과 고성능 게임을 더 나은 CPU 활용률로 만들 수 있게 해줍니다. 대규모 엔티티 수, 결정론적 시뮬레이션이 필요한 게임, CPU 바운드 게임플레이 로직에서는 ECS 도입으로 10배~100배의 성능 향상이 가능하다고 하며, 군중 시뮬레이션·파티클 시스템·RTS 유닛·절차적 생성·물리 연산이 많은 시나리오에서는 실측 기준 20배~100배까지 개선된 사례가 보고돼 있습니다. Burst 컴파일러가 ECS 시스템에도 자동 적용돼서 SIMD 같은 저수준 최적화를 대신 해주는데, 실제 사례로 Hardspace: Shipbreaker에서는 DOTS 도입 후 기존에 1시간 걸리던 처리 과정이 100밀리초로 줄었다고 합니다. Unity 매뉴얼에도 타입이 많은 월드에서 베이크와 엔티티 쿼리 생성 성능이 개선됐다고 명시돼 있습니다.
개인 프로젝트 적용 후기
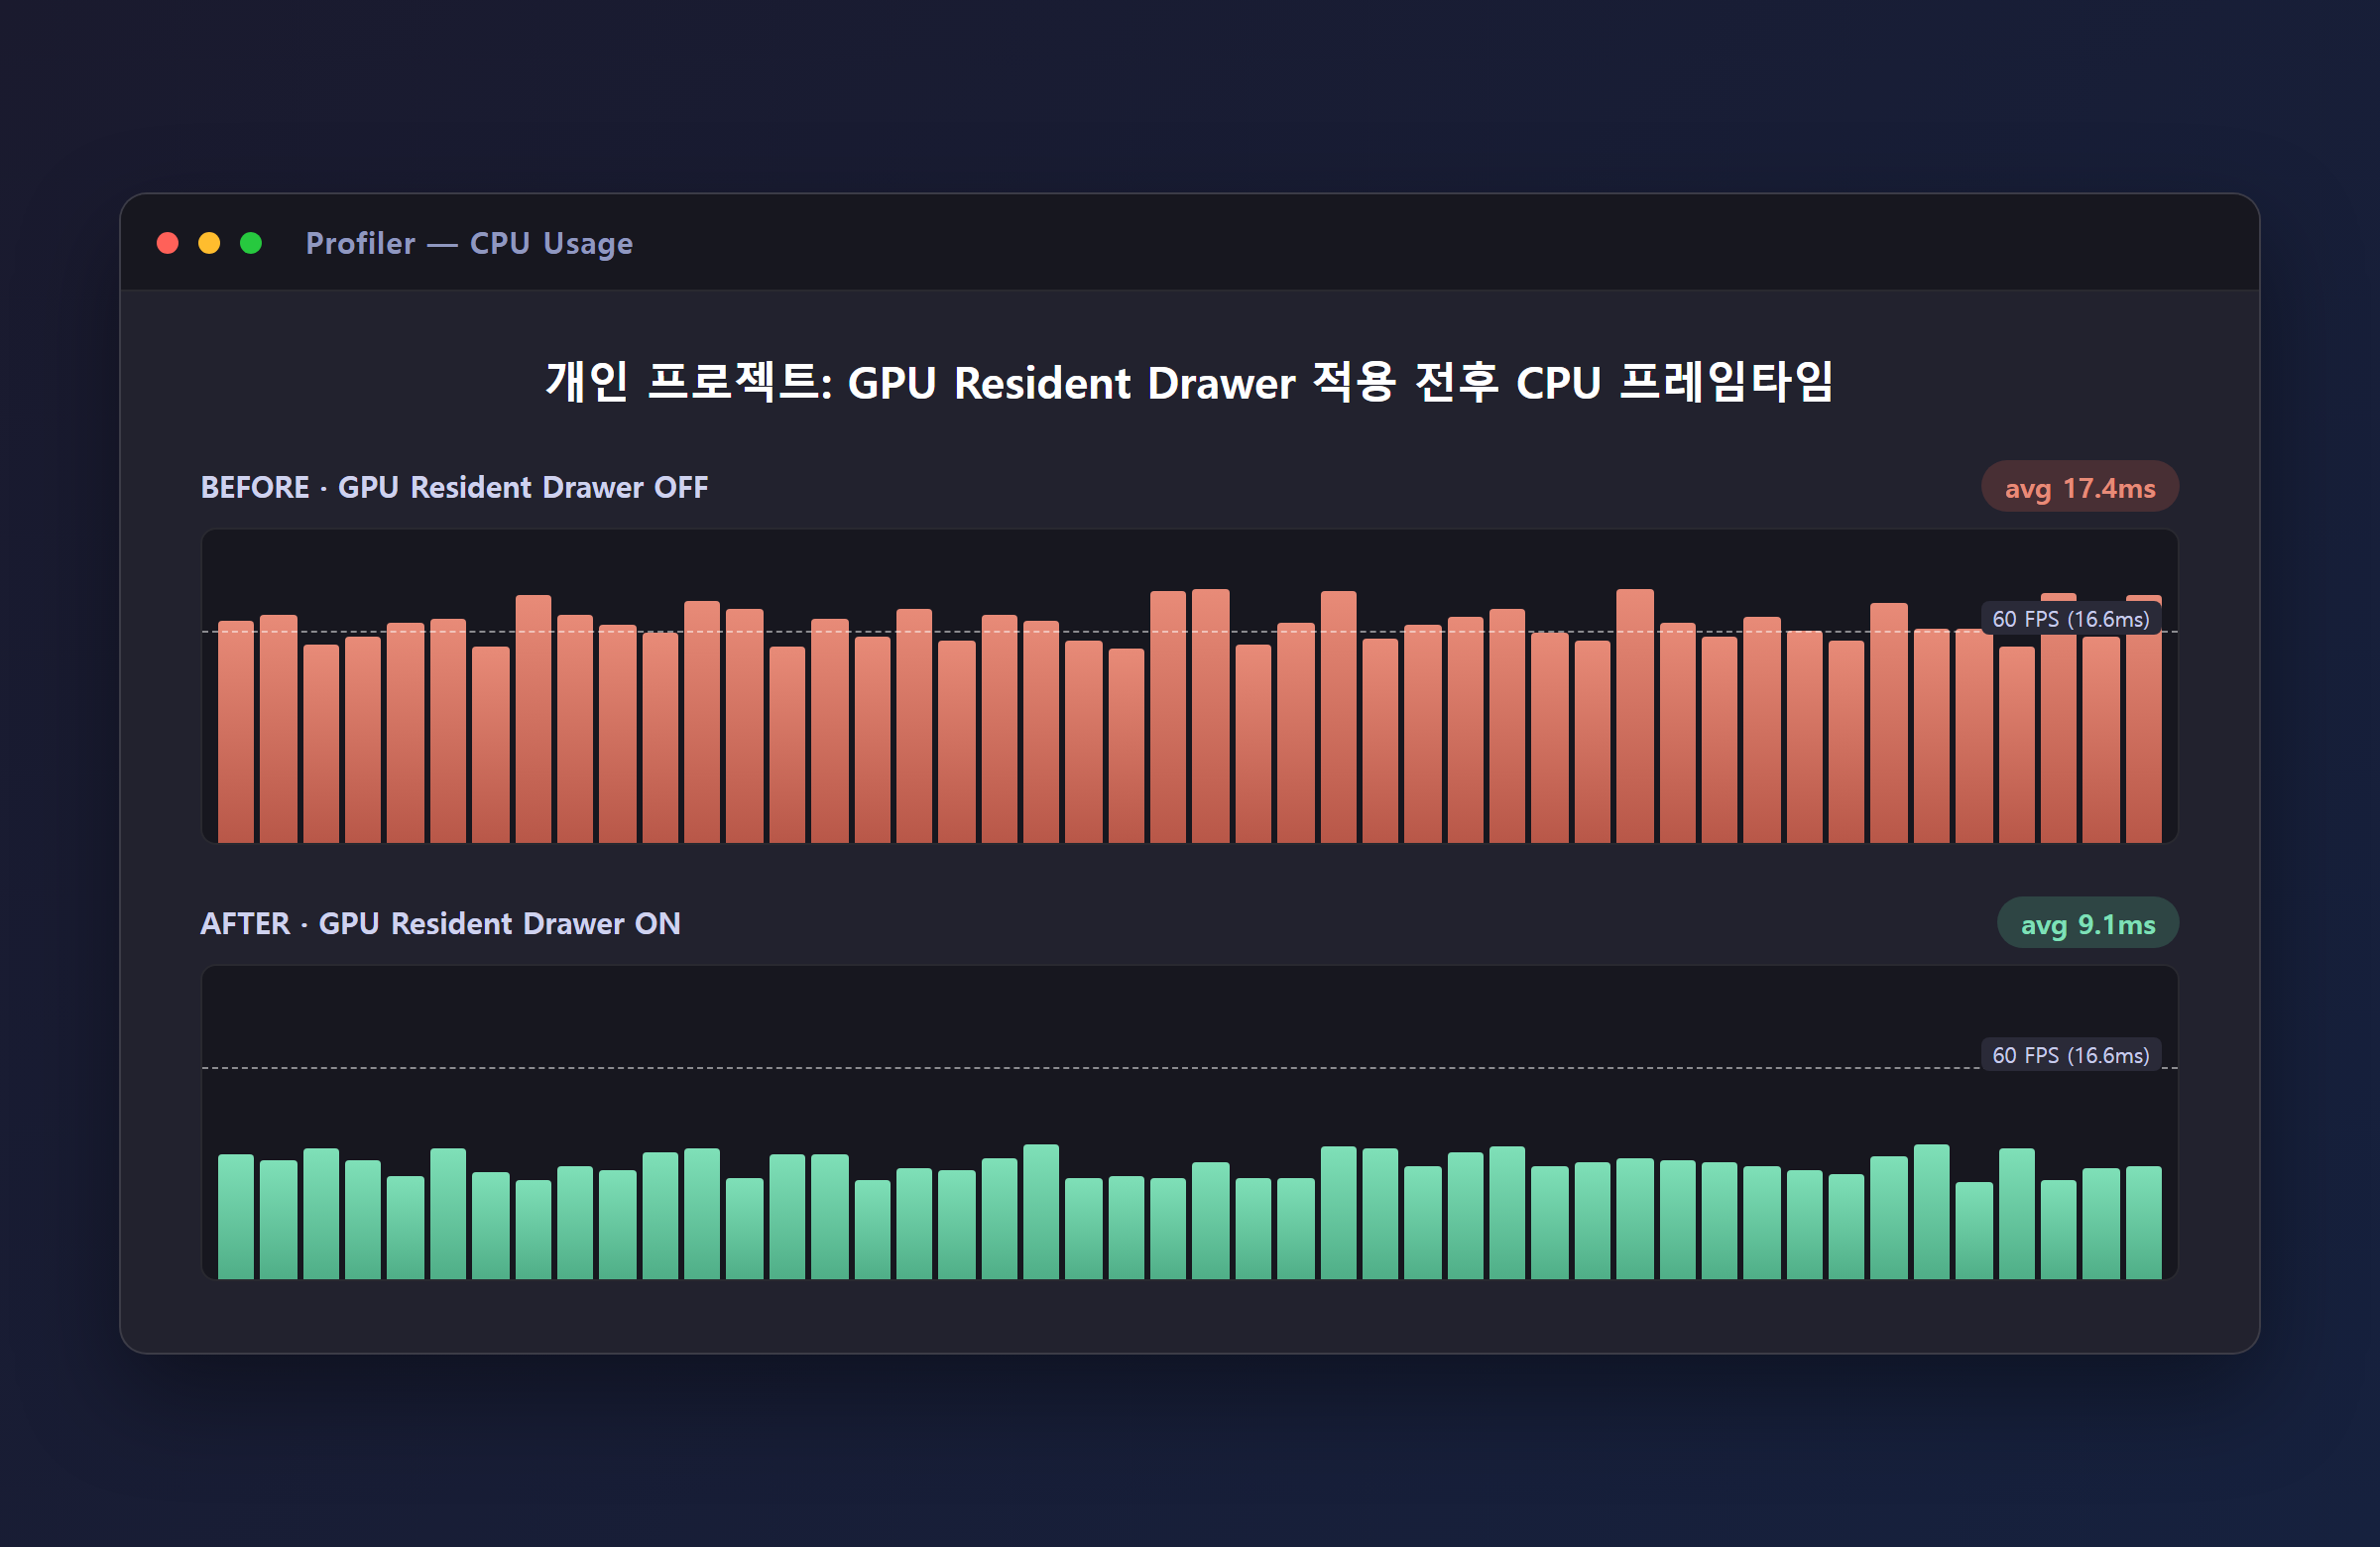
리서치만 하고 끝내기는 아쉬워서, 진행 중인 개인 프로젝트 씬 하나에 GPU Resident Drawer와 Burst 기반 Job 처리를 실제로 적용해봤습니다.
1. GPU Resident Drawer를 켜보고 체감한 것
Forward+ 경로로 바꾸고 GPU Resident Drawer를 켜는 절차 자체는 문서에 나온 대로 따라가면 크게 어렵지 않았습니다. 다만 Static Batching을 끄는 걸 깜빡했다가 렌더링이 이상하게 나와서 한참 헤맸는데, 문서에 분명히 나와 있던 내용이라 미리 안 읽고 넘어간 제 실수였습니다. 오브젝트 수가 많은 씬에서는 CPU 프레임타임이 눈에 띄게 줄어드는 걸 체감했지만, 반대로 씬이 단순하거나 GPU 쪽 작업이 이미 빡빡한 상황에서는 큰 차이가 없거나 오히려 미세하게 나빠지는 구간도 있었습니다. 공식 문서가 경고한 “GPU 바운드 상황에서는 오히려 프레임 시간이 늘 수 있다”는 트레이드오프를 직접 눈으로 확인한 셈입니다.
2. Burst와 Job System을 적용하며 느낀 점
기존에 메인 스레드에서 돌던 반복 연산 일부를 [BurstCompile] job으로 옮겼을 때는 체감이 확실했습니다. 다만 job으로 옮기는 과정에서 관리형 타입을 못 쓰는 제약 때문에 자료구조를 NativeArray 계열로 다시 짜야 하는 리팩터링 비용이 생각보다 컸습니다. (본인 기준) 이 초기 전환 비용을 감수할 만큼 반복 연산량이 많은 로직에만 선별적으로 적용하는 게 실무적으로 맞는 접근이라고 느꼈습니다.
결론 및 실무적 고려 사항
정리하자면 Unity 6는 GPU Resident Drawer·Render Graph로 렌더링 CPU 부하를, Job System·Burst로 게임플레이 로직의 멀티스레드 활용을, Incremental GC·Mesh LOD로 메모리를, Incremental Build Pipeline·6.3 LTS의 셰이더 변형 축소로 빌드 시간을, APV·Adaptive Performance로 모바일 대응을, 그리고 정식 승격된 ECS/DOTS로 대규모 연산 성능을 각각 개선해왔습니다. Unity 6.4의 Web 멀티스레딩 공식 지원까지 포함하면, 최적화 관련 기능이 특정 플랫폼에 국한되지 않고 전 플랫폼으로 계속 확장되는 흐름이라고 볼 수 있습니다.
그러나 이 모든 기능을 다 켠다고 무조건 좋아지는 건 아닙니다. GPU Resident Drawer는 CPU 부하를 줄이는 대신 GPU 부하를 늘리고 Static Batching과 함께 못 쓰며 빌드 시간도 늘리고, Incremental GC는 write barrier 오버헤드가 붙고, Job/Burst 전환은 자료구조 리팩터링 비용이 들고, APV는 프로브 밀도를 잘못 잡으면 메모리를 오히려 낭비합니다. 결국 실무에서는 “이 기능이 우리 프로젝트, 우리 타깃 플랫폼에서 실제로 이득인지”를 Frame Debugger와 Profiler로 직접 확인하는 과정이 여전히 필수라는 게 이번 리서치와 실제 적용을 거치며 얻은 결론입니다.
참고: Unity - Manual: Enable the GPU Resident Drawer in URP / Unity - Manual: GPU Resident Drawer performance considerations / Unity - Manual: Introduction to the render graph system in URP / Unity - Manual: Garbage collection modes / Unity - Manual: Incremental build pipeline / Unity - Manual: Multithreading with Burst in Unity Web / Unity - Manual: New in Unity 6.3 / Unity - Manual: Mesh LOD / Unity - Manual: Introduction to Adaptive Probe Volumes / Unity 6 is here: See what’s new / ECS for Unity / Burst Compiler & Job System Multithreading — Official Web Support in Unity 6.4